Kosaraju
Kosaraju 算法是求解有向图强连通分量(Strongly Connected Components, SCC)的经典线性时间算法,其核心思想为“原图后序标记,反图逆向剥离”。
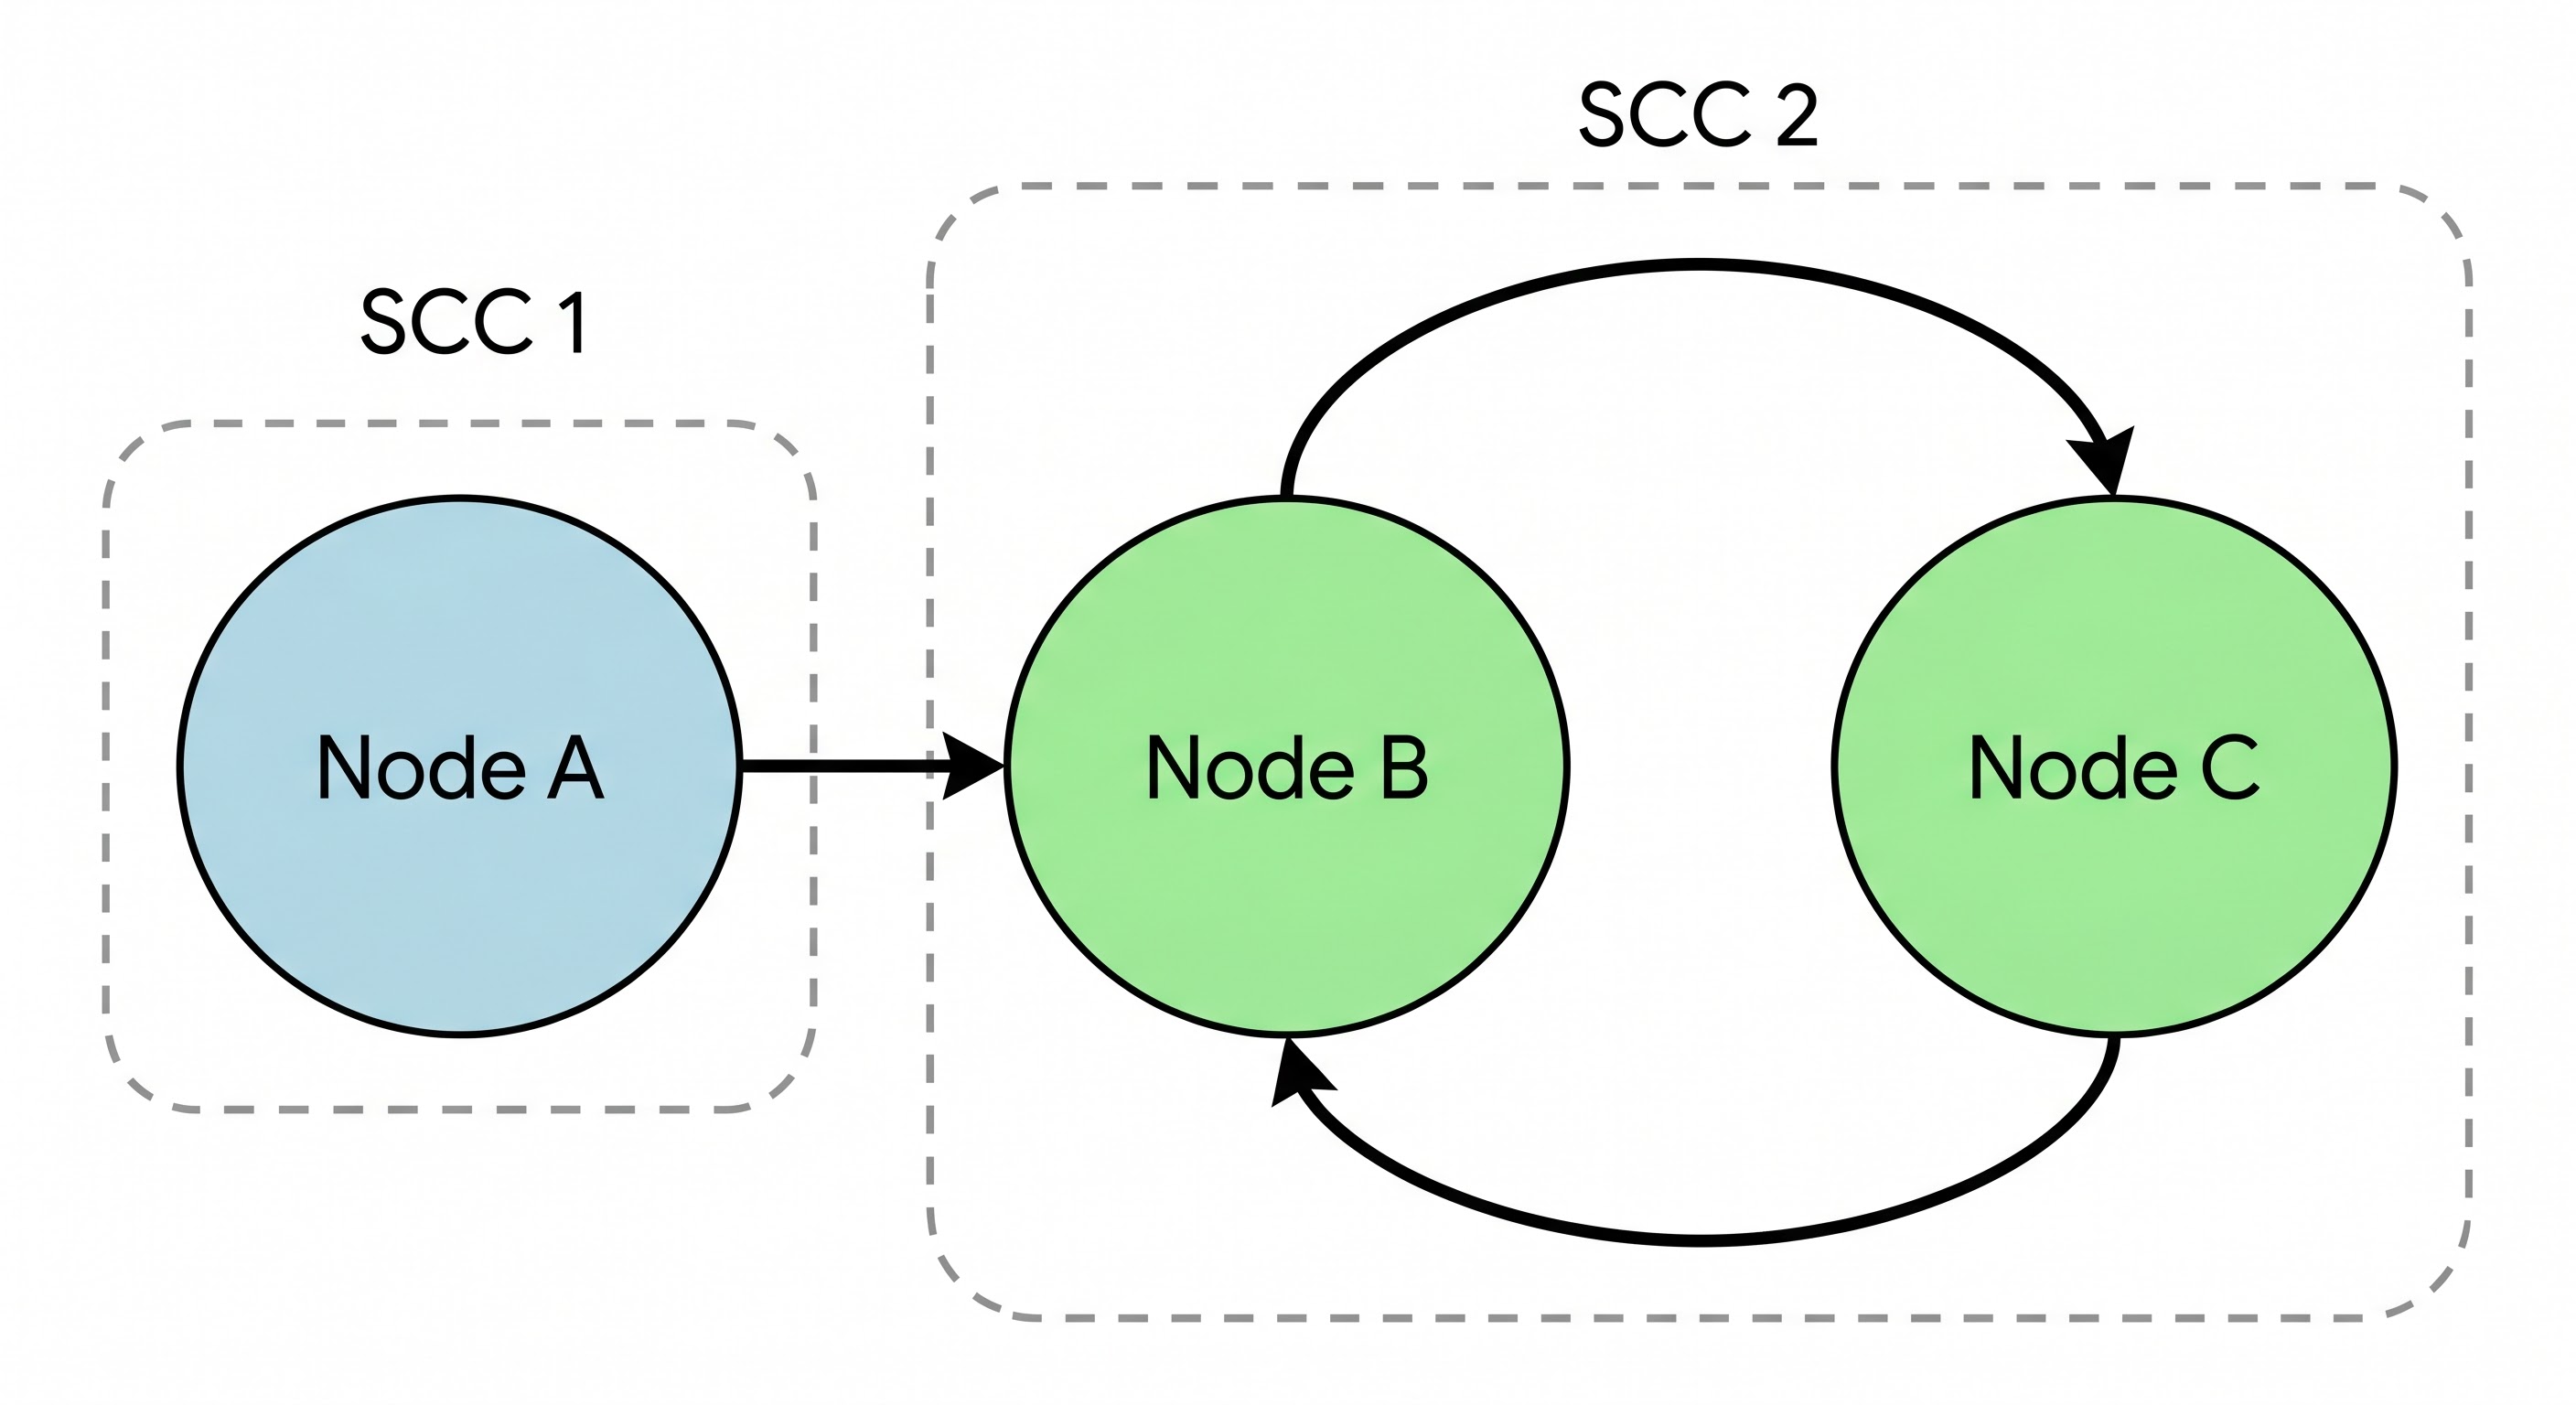 ---
一、 数学原理与证明
将有向图
1. 离开时间引理(Finishing Time Lemma)
设分量
若在 DAG
证明:考虑原图第一遍 DFS 首次接触到
- 情况 1:DFS 先访问到
中的点。由于从 可达 ,且 DAG 无环导致 无法反向到达 ,DFS 会在遍历完 中的所有可达节点并全部回溯后,才最终回溯离开 。因此 。 - 情况 2:DFS 先访问到
中的点。由于 无法到达 ,DFS 将完整遍历 并全部回溯结束;此时 尚未被访问。随后外层循环才从 启动新的搜索。因此 。
2. 反图隔离性(Transposition Isolation)
取
若按
- 最大
节点必然属于 DAG 中的源点分量(出度存在但入度为 0 的分量 )。 - 在反图
中,该分量变为汇点分量(入度存在但出度为 0)。 - 此时在
上以该节点启动 DFS,搜索流无法通过任何反向边流出 ;同时由强连通性, 内部节点彼此完全可达。搜索范围被严格限制在 内部,完整且独立地剥离出一个 SCC。
二、 算法执行步骤
- 图的转置:读入每条有向边
时,同时在原图建立 ,并在反图建立 。 - 第一遍 DFS(后序推进):在原图上遍历所有未访问节点。当某个节点的出边全部遍历完毕准备回溯时,将该节点压入栈或序列
ord。 - 第二遍 DFS(反图着色):将序列
ord倒序扫描(即离开时间由大到小)。若当前节点未被分配 SCC 编号,则在反图上启动 DFS,本次遍历到的所有节点分配同一个分量编号。
拓扑序副产物:第二遍 DFS 依次剥离的分量编号
天然满足缩点 DAG 的正向拓扑序。在缩点后进行 DP 时,无需重新执行拓扑排序。
三、 模板
该实现追求极简与零额外空间冗余,时间复杂度严格为
cpp
#include <bits/stdc++.h>
using namespace std;

const int MAXN = 200005;
vector<int> g[MAXN], rg[MAXN];
vector<int> ord;
bool vis[MAXN];
int scc[MAXN], scc_cnt;

// 第一遍 DFS:记录原图后序离开时间
void dfs1(int u) {
    vis[u] = true;
    for (int v : g[u]) {
        if (!vis[v]) dfs1(v);
    }
    ord.push_back(u);
}

// 第二遍 DFS:在反图上沿汇点分量染色
void dfs2(int u, int c) {
    scc[u] = c;
    for (int v : rg[u]) {
        if (!scc[v]) dfs2(v, c);
    }
}

// n: 点数 (1-indexed), m: 边数
void kosaraju(int n) {
    ord.clear();
    for (int i = 1; i <= n; i++) {
        vis[i] = false;
        scc[i] = 0;
    }
    scc_cnt = 0;

    for (int i = 1; i <= n; i++) {
        if (!vis[i]) dfs1(i);
    }
    for (int i = n - 1; i >= 0; i--) {
        int u = ord[i];
        if (!scc[u]) dfs2(u, ++scc_cnt);
    }
}四、 Kosaraju 与 Tarjan 的工程选型权衡
| 维度 | Kosaraju 算法 | Tarjan 算法 |
|---|---|---|
| 代码量 / 心智负担 | 极低(两个标准 DFS,无时间戳维护) | 中等(需维护 dfn、low、栈及在栈标记) |
| 拓扑序生成 | 天然为正向拓扑序(可以直接做 DAG DP) | 天然为逆拓扑序(需倒序遍历进行 DP) |
| 常数 / 耗时 | 稍大(两遍 DFS + 反图存图) | 更优(一遍 DFS 遍历) |
| 空间开销 |
例题: abc478 - E 题解:abc478 - E 题解